- 登入
- 註冊
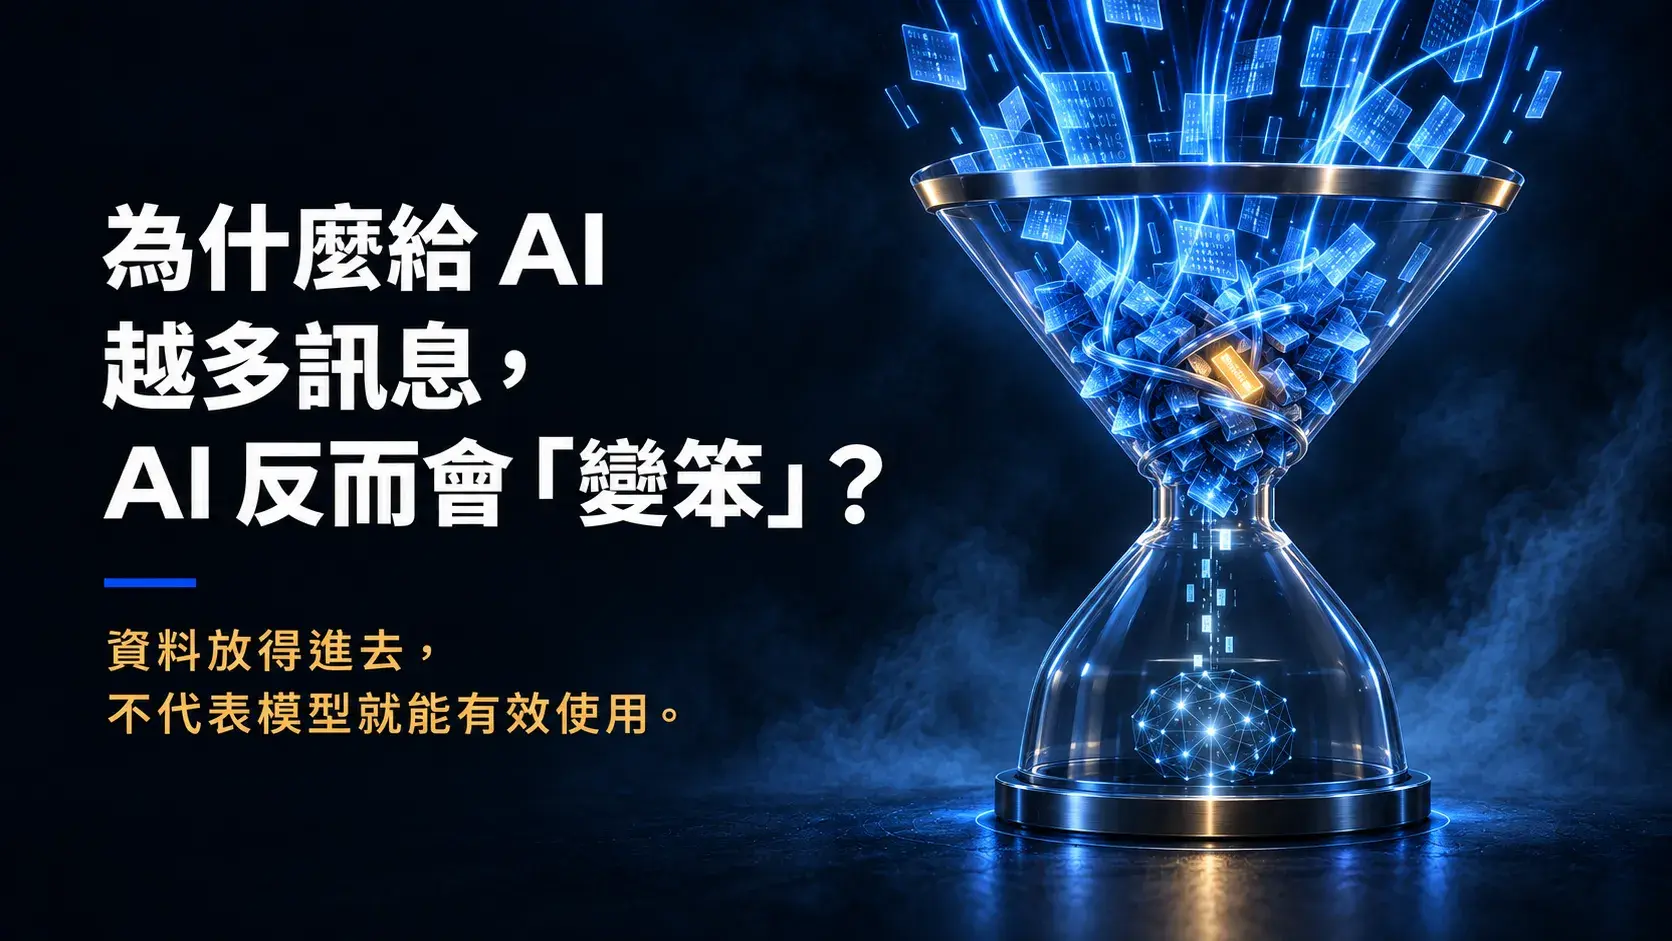
我們常以為,AI 回答得不夠好,是因為它知道得不夠多。只要多給一些文件、多補一些背景資料,再透過 RAG 找出相關內容,答案應該就會更準確。
RAG(檢索增強生成)的做法,是先從資料庫或知識庫找出相關文件,再交給大型語言模型作為回答依據。企業知識管理、內部問答與客服系統,都可以運用這種方式,讓 AI 參考企業自己的資料。
但找到資料、把資料交給模型,還不代表模型就能正確運用。
2025 年,Chroma 創辦人 Jeff Huber 在一場以「RAG 已死,上下文工程才是王道」為題的訪談中,提出了對 RAG 常見做法的批評:當開發者把整套流程簡化成「搜尋幾段文字,再全部丟給 AI」,就容易忽略真正影響答案品質的資訊選擇與整理工作。
明明已經找到相關資料,也把更多背景資訊交給 AI,為什麼它還是會忽略指令、抓錯重點,甚至給出不符合情境的答案?
資料放得進去,不代表模型就能有效使用。
除了檢索到什麼,團隊還需要決定哪些資訊應該保留、哪些應該排除,以及如何組合成適合當前任務的內容。這正是「上下文工程」要處理的問題。
Jeff Huber 對 RAG 的批評,主要來自這個詞在實務上被過度簡化。
檢索、整理資訊與生成答案,各自有不同的問題需要解決。若把它們視為一個裝好就能運作的功能,就容易跳過每個環節的設計與評估。
例如,許多系統仰賴向量檢索,找出與使用者問題「語意相似」的文件。但語意相似,只是判斷相關性的一種線索。
以客服系統為例,使用者詢問某項商品的退貨條件,系統可能同時找到舊版退貨政策、其他商品的規則,以及一般性的購物說明。這些內容都與退貨有關,卻不一定適用於這次問題。
如果沒有先確認商品、版本與適用條件,就把搜尋結果全部交給模型,AI 仍可能引用錯誤的規則。
因此,「RAG 已死」這個說法所指向的反思,是團隊需要更仔細地設計檢索與資訊處理流程。檢索仍然重要,只靠一次搜尋,往往不足以完成這件事。
Chroma 在 2025 年發布的上下文腐爛研究測試了 18 個大型語言模型,發現即使任務本身維持相同難度,隨著輸入內容增加,模型表現仍可能下降,而且不同模型受到的影響並不一致。
這種隨著上下文增長,模型處理資訊的可靠度下降的現象,被稱為「上下文腐爛」(Context Rot)。
它提醒我們,模型能接收多少資料,和它能多可靠地使用這些資料,是不同的能力。
當一份輸入同時包含大量背景、重複內容,以及看似相關卻無法回答問題的資訊,模型就必須先辨認哪些內容真正有用,再據此回答。
以剛才的客服情境來說,如果當次問題只需要一份現行政策,卻同時附上多個歷史版本,模型就多了一項判斷工作:哪一份才是現在應該採用的規則?
這不代表每增加一段資料,答案就一定變差。但它說明了:增加資訊量,不能直接當成提升答案品質的方法。
上下文工程(Context Engineering),就是有系統地挑選、整理與維護模型執行任務時需要的資訊。
這些資訊可能包括任務指令、參考文件、對話紀錄,以及工具查詢的結果。
重點在於,這次回答究竟需要哪些內容?哪些資訊已經過時?哪些內容雖然相關,卻不會幫助模型完成任務?
Jeff Huber 在〈The Rise of Context Engineering〉中,把資訊選擇分成兩個階段:先廣泛蒐集可能有用的資料,再篩選出真正需要的內容。
這也讓上下文工程成為可以逐步設計、測試與改善的工作。
當 AI 回答錯誤時,先確認是哪個環節出了問題。
是根本沒有找到正確文件?找到的資料已經過時?排序把重要內容放得太後面?還是模型拿到了正確資料,卻沒有依照資料回答?
語意檢索、關鍵字搜尋、條件過濾與重新排序,都有各自的作用。把流程拆開評估,才能知道應該改善哪一部分。
例如,語意搜尋可以協助找到不同說法但意思相近的內容;關鍵字搜尋則有助於鎖定產品名稱、型號或專有名詞。版本、日期等條件,也應該納入資料篩選。
檢索的第一階段,可以結合語意與關鍵字搜尋,盡量找齊可能有用的資料。
第二階段,再透過重新排序(reranking),依照當次問題判斷哪些內容最值得保留,最後才組成提供給模型的上下文。
Latent Space 的訪談整理以先找出約 200–300 個候選項目,再挑選約 20–40 個相關片段作為流程示例。這些數字是參考規模,實際數量仍需依任務、文件長度與測試結果調整。
重點是讓「找得完整」與「選得精準」分別得到處理。
選出資料之後,還需要整理。
重複的段落可以合併,過時的資訊應該排除,必要的來源、日期與適用條件則要保留。任務指令與參考資料,也應該清楚區分。
精簡時同樣要小心:如果刪掉例外條件、限制或關鍵證據,即使內容變短,答案也可能變得不完整。
因此,好的上下文應該保留完成任務所需的資訊,同時減少無助於判斷的內容。
當 AI 表現不如預期,團隊可以先回頭問三個問題:
最後一個問題,需要用測試確認。
可以先整理一小組真實問題,標註每個問題應該找到哪些資料、答案必須包含哪些重點。之後每次更換檢索方式、調整排序或精簡內容,都使用同一組問題比較結果。
這樣,團隊才能逐步掌握:哪些資訊有助於模型完成任務,哪些內容只是增加了負擔。
「Garbage in, garbage out。做好上下文工程,AI 才能真正創造價值。」
[1] Context Rot: How Increasing Input Tokens Impacts LLM Performance
Chroma,2025。探討輸入長度、干擾資訊與內容特性如何影響模型表現。
[2] The Rise of Context Engineering
Jeff Huber,2025。介紹資訊蒐集、篩選與持續評估上下文品質的方法。
[3] “RAG is Dead, Context Engineering is King” — with Jeff Huber of Chroma
Latent Space,2025。討論 RAG 的常見誤解、上下文腐爛與檢索系統的設計方式。
上下文腐爛是指模型在處理更長的輸入時,表現可能變得不可靠。增加資料不一定能改善答案,尤其當輸入包含大量無關內容,或看似相關卻容易誤導的資訊時。
先釐清任務需要哪些資訊,再檢查資料是否找得完整、選得精準,以及有沒有保留必要條件。最後,使用固定的真實問題測試,確認每次調整是否讓答案更準確。
RAG 仍然可以協助模型取得外部資料。需要反思的是,把它簡化成「找到相似文件,再全部交給模型」的做法。資料的適用性、篩選、排序與組合方式,都會影響最後的答案。