- 登入
- 註冊
我們常以為,只要提供更多高品質示範,再投入資源訓練,AI Agent 就能做出更可靠的決策。
但實際使用時,團隊可能發現:熟悉的任務做得不錯,一換到沒見過的情境,Agent 就開始選錯操作、忽略限制,甚至無法完成任務。
這不一定是訓練資料不夠多,也可能與 Agent 如何學習有關。
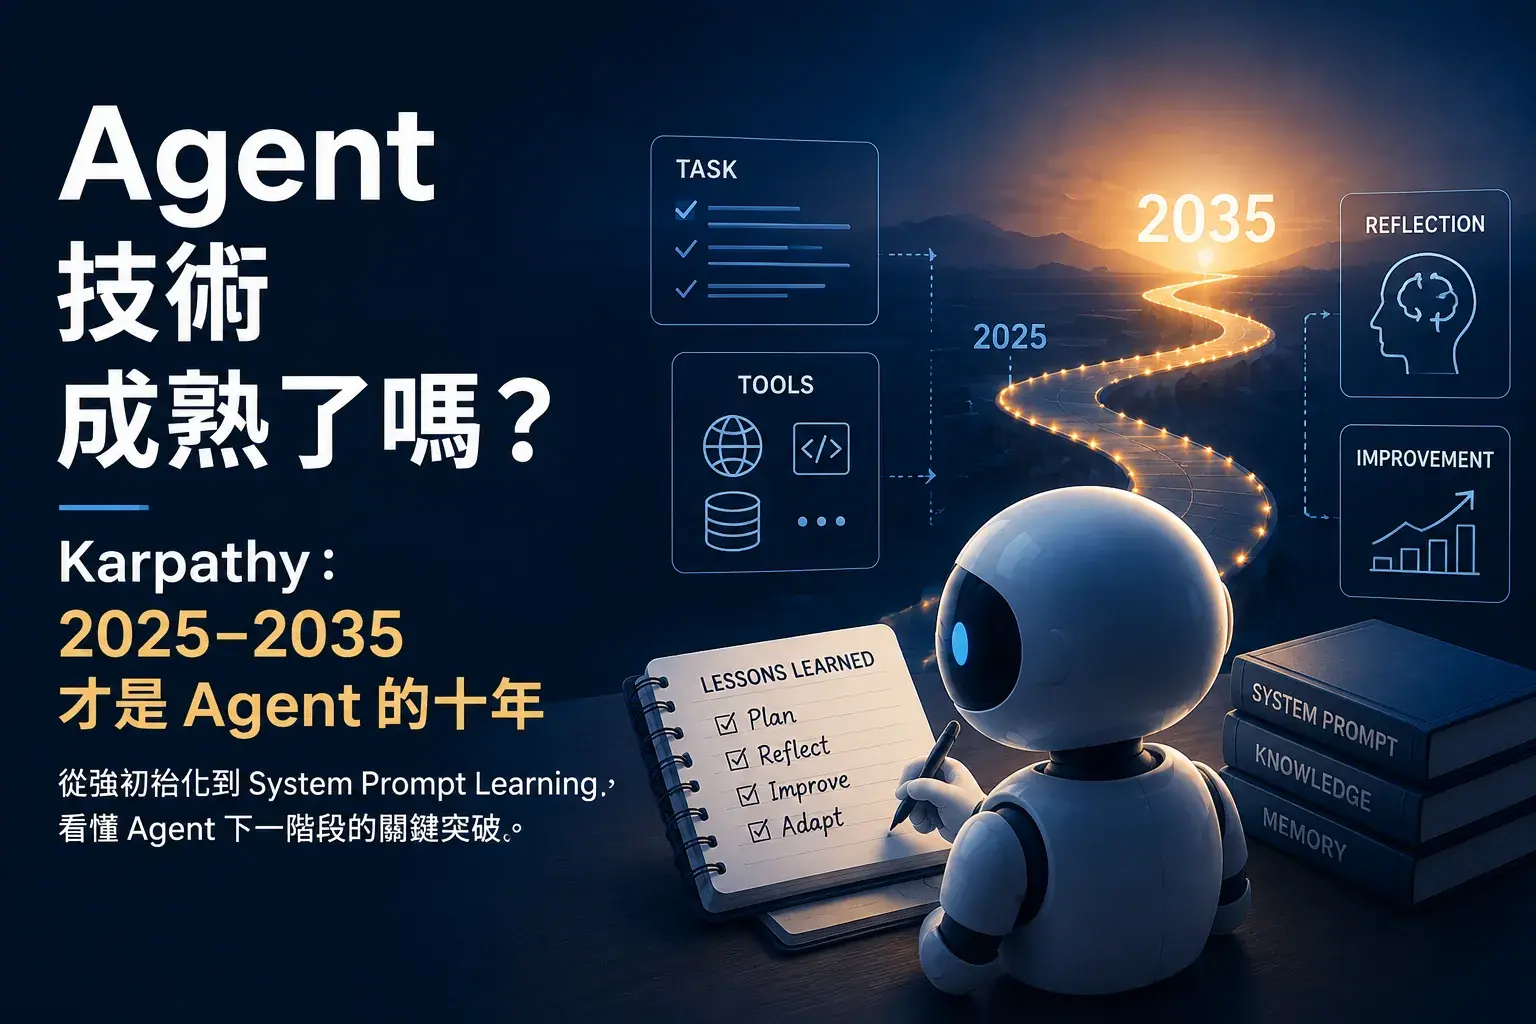
Meta 與合作研究團隊在 2025 年發表的〈Agent Learning via Early Experience〉提出「早期經驗」:讓 Agent 在訓練階段嘗試不同操作,觀察環境如何改變,再把行動與後果轉成學習資料,幫助它在新情境中做出更好的決策。
為什麼 Agent 看過許多正確示範,遇到新情境時,仍可能不知道下一步該怎麼做?
示範可以教它「這種情況應該做什麼」,卻不一定讓它理解「為什麼這樣做,以及換一種做法會發生什麼」。
當環境超出訓練資料的涵蓋範圍,這個差距就可能浮現。
除了學習正確操作,Agent 也需要學習操作帶來的後果。
如果它能掌握環境中的規律,就更有機會判斷不同選擇的影響,並把學到的經驗運用到未見過的情境。
這正是「早期經驗」研究想補上的能力。
監督式微調(SFT)可以透過專家示範,教 Agent 在特定情境下採取合適的行動。
例如,在購物網站上,示範可以教它如何搜尋商品、查看規格,再選出符合需求的品項。
但真實任務充滿變化:商品缺貨、頁面改版、使用者多了一項限制,都可能讓原本的操作方式不再適用。訓練資料很難事先涵蓋每一種狀況,而持續蒐集高品質示範,也需要成本。
強化學習(RL)則讓 Agent 透過嘗試與回饋改善行為,但它也有難題。許多真實環境不會提供清楚的對錯分數;有些任務則要經過很多步,才知道是否成功,讓模型難以判斷究竟是哪一步出了問題。
因此,研究提出了一個問題:即使沒有明確的獎勵,Agent 能不能從行動後的環境變化中學習?
世界模型(World Model),可以理解為 Agent 對環境運作方式的掌握:在目前的狀態下,採取某個行動,接下來可能發生什麼?
例如,在購物網站上,點擊商品會進入詳情頁,設定價格條件會改變搜尋結果,而商品缺貨可能讓原本的購買路徑無法繼續。
這些行動與後果之間的關聯,是判斷與規劃的基礎。
David Silver 與 Richard Sutton 在〈Welcome to the Era of Experience〉中,也強調讓 AI 從與環境互動的經驗中學習,並透過世界模型預測行動後果的價值。
這裡的「理解」,不代表 AI 已經具有人類式的思考,而是它能否學到有助於決策的環境規律。
研究探討了兩種方法,分別讓 Agent 學習環境變化,以及不同選擇之間的差異。
隱性世界模型(Implicit World Modeling,IWM)的做法,是蒐集 Agent 與環境互動的資料,讓模型根據當下狀態與採取的行動,學習預測下一個狀態。
接著,再使用專家示範進行微調,學習合適的操作。
也就是說,Agent 不只學「專家選了哪個動作」,也先練習理解「這個動作會讓環境產生什麼變化」。
這些規律會透過訓練納入模型參數,因此稱為「隱性」世界模型。
自我反思(Self-Reflection,SR)則從專家示範中的情境出發,讓 Agent 嘗試其他行動,觀察結果,再比較兩種做法造成的差異。
例如,使用者要找一件符合預算的商品。專家選擇了符合需求的品項,Agent 卻點進外觀相似、價格超出預算的商品。
這時,反思資料就可以指出:這次選擇忽略了預算限制。
最後,研究把這些反思與專家行動一起用於微調,讓 Agent 學習更能跨情境使用的決策原則。
兩種方法都不需要為探索資料提供明確的獎勵,但仍會使用專家示範。 這裡的自我反思,也不只是請 AI 在對話中「再想一次」,而是把互動結果整理成資料,實際用於模型訓練。
研究在八種環境、不同模型上進行實驗。論文的 2025 年版本報告,相較於純模仿學習,早期經驗方法的成功率平均提升 9.6 個百分點;在分布外情境(OOD,也就是與訓練情境不同的測試條件)中,平均提升 9.4 個百分點。
在具備可驗證獎勵的環境裡,以早期經驗訓練後的模型作為起點,再進行強化學習,也取得了更好的最終表現。〔1〕
這些結果支持早期經驗的價值,但不代表它能解決所有 Agent 的不穩定問題,也不能保證企業導入後會得到相同幅度的改善。
對導入 Agent 的團隊來說,這篇研究提供了一個值得檢查的方向:訓練資料是否只有成功示範,還是也包含行動過程、環境變化,以及失敗原因?
如果只留下最後答案,就很難看見 Agent 在哪個狀態做錯選擇,又因此造成什麼後果。
實務上,可以先在可控的測試環境中,整理「當下情境、採取行動、實際結果」的紀錄,再評估如何把這些經驗轉成訓練資料。
最後,仍需要用未見過的情境測試,確認 Agent 是否真的學到可運用的規律,而不只是更熟悉原本的題目。
「數據與規則,終究只是腳踏車輔助輪;真正的智慧,誕生於 AI 拆掉輔助輪,學會自我平衡與前進那刻。」
[1] 隱性世界模型與自我反思:透過早期經驗提升 Agent 決策能力|Agent Learning via Early Experience(Meta 與合作研究團隊,2025)
[2] 從人類數據到經驗學習|Welcome to the Era of Experience(David Silver & Richard Sutton,2025)
以上文章整理自【數創電子報 Vol.12】AI Agent 總是不穩?Meta 研究「早期經驗」給了解方